降低Claude Code使用成本的關鍵-Prompt Cache命中率
降低Claude Code使用成本的關鍵-Prompt Cache命中率
周季賢 Tony Chou
- 精誠資訊 恆逸教育訓練中心 資深講師
- 技術分類:程式設計
Claude Code 是 Anthropic 推出的命令列 AI 開發工具,它可以直接在終端機中理解專案結構、修改程式碼並執行指令。隨著導入的團隊愈來愈多,一個問題也隨之浮現:同樣是一整天的開發工作,為什麼有些人的用量始終在安全範圍內,有些人卻在下午就收到額度警告?
多數開發者檢視花費的方式,是在對話中輸入 /cost 指令查看總額,然後得到一個沒有太大幫助的結論:這個月用得比較兇。然而 token 的使用量從來不是唯一的變數,因為同樣一份內容送進模型,計價方式可以差到數十倍之多。
造成這個差距的機制稱為 Prompt Cache(提示快取)。筆者在本文中將說明它的計價邏輯、如何觀察自己的命中率,以及有哪些常見的操作會在不知不覺間讓快取失效。
Prompt Cache的計價方式
在說明計價之前,必須先解釋一個名詞:TTL(Time To Live,存活時間),指的是一份快取從建立之後,可以在伺服器端保留多久。超過這個時間,快取就會被清除,下一次請求即使內容一模一樣,也必須重新付費建立。
TTL 有一個很重要的特性:它是從最後一次被使用的時刻起算,而不是從建立的時刻起算。也就是說,只要您持續在對話中來回,每一次命中都會讓計時重新開始,5 分鐘的快取可以一路延續好幾個小時;但只要中間離開座位超過 5 分鐘沒有動作,快取就過期了,回座後的第一次發問的Token計價會是全額,這也是為什麼開會回來之後的第一輪特別貴。
了解 TTL 之後,就可以看懂 Claude 系列模型的快取計價方式。它由三個固定倍率構成,以基礎輸入價格為基準:
| 項目 | 倍率 | 說明 |
|---|---|---|
| 快取讀取 | 0.1 倍 | 命中時的計價,相當於打一折 |
| 快取寫入(TTL 5 分鐘) | 1.25 倍 | 預設值。建立快取時的額外成本,存活時間較短 |
| 快取寫入(TTL 1 小時) | 2 倍 | 需自行指定。存活時間較長,但建立成本較高 |
由上表可以看出兩件事。第一,快取命中時成本會下降九成;第二,快取寫入是要付費的,如果每一輪都在重寫快取,反而會比完全不使用快取多付兩成五的費用。
這個機制對 Claude Code 這類工具的影響特別明顯。在一個對話工作階段(session)中,系統提示、工具定義清單、專案的 CLAUDE.md、已載入的技能(Skill)以及先前所有輪次的對話內容,會組成一段很長而且內容固定的「前綴」,並且在每一輪都重新送出。這段前綴命中快取時幾乎不花錢;一旦失效,整段就會重新計費。
這裡必須先釐清一個名詞。本文所提到的「一輪」,指的是一次送往模型的請求,而不是使用者的一次發問。Claude Code 會自行呼叫工具,因此使用者輸入一則指令之後,它可能會讀取檔案、執行測試、修改程式碼,每當一項工具執行完畢、結果回傳,就必須帶著整段前綴再向模型送出一次請求。換句話說,一次發問往往會展開成十幾次請求。
這正是快取失效的代價比直覺想像嚴重許多的原因:所謂「每一輪都失效」,實際的意思是「每一次工具往返都付一次全價」。各位讀者可以在 /cost 的輸出中看到 requests 這個欄位,它計算的就是這個單位。
以下用一個實際的數字來說明。假設前綴長度為 8 萬 token、模型輸入價格為每百萬 token 10 美元,在一小時內來回了三十輪:
- 三十輪全部命中:成本為一次寫入加上二十九次讀取,約 0.10 + 0.23 = 0.33 美元。
- 三十輪全部失效:成本為三十次全價輸入,即 8 萬 × 30 × 10 ÷ 100 萬 = 24 美元。
兩者相差七十倍以上,但使用者的操作體感完全相同,送出的 token 數量也一模一樣。因此真正需要管理的指標並不是用量,而是命中率。
快取是如何比對的
要判斷哪些操作會讓快取失效,必須先了解比對的規則。Prompt Cache 採用的是「前綴比對」,也就是從請求的開頭往後逐字節比較,一旦遇到不同的內容就停止,該位置之後的全部內容都必須重新計算。
這個規則帶來一個相當反直覺的結論:愈靠前面的內容愈不能變動。對話的最後多了一輪問答,前面的部分仍然全部命中,只有新增的部分需要付全價;但如果工具清單少了一個工具,或是系統提示多了一行文字,整段 8 萬 token 就會全部作廢,即使後面的對話一個字都沒有改變。
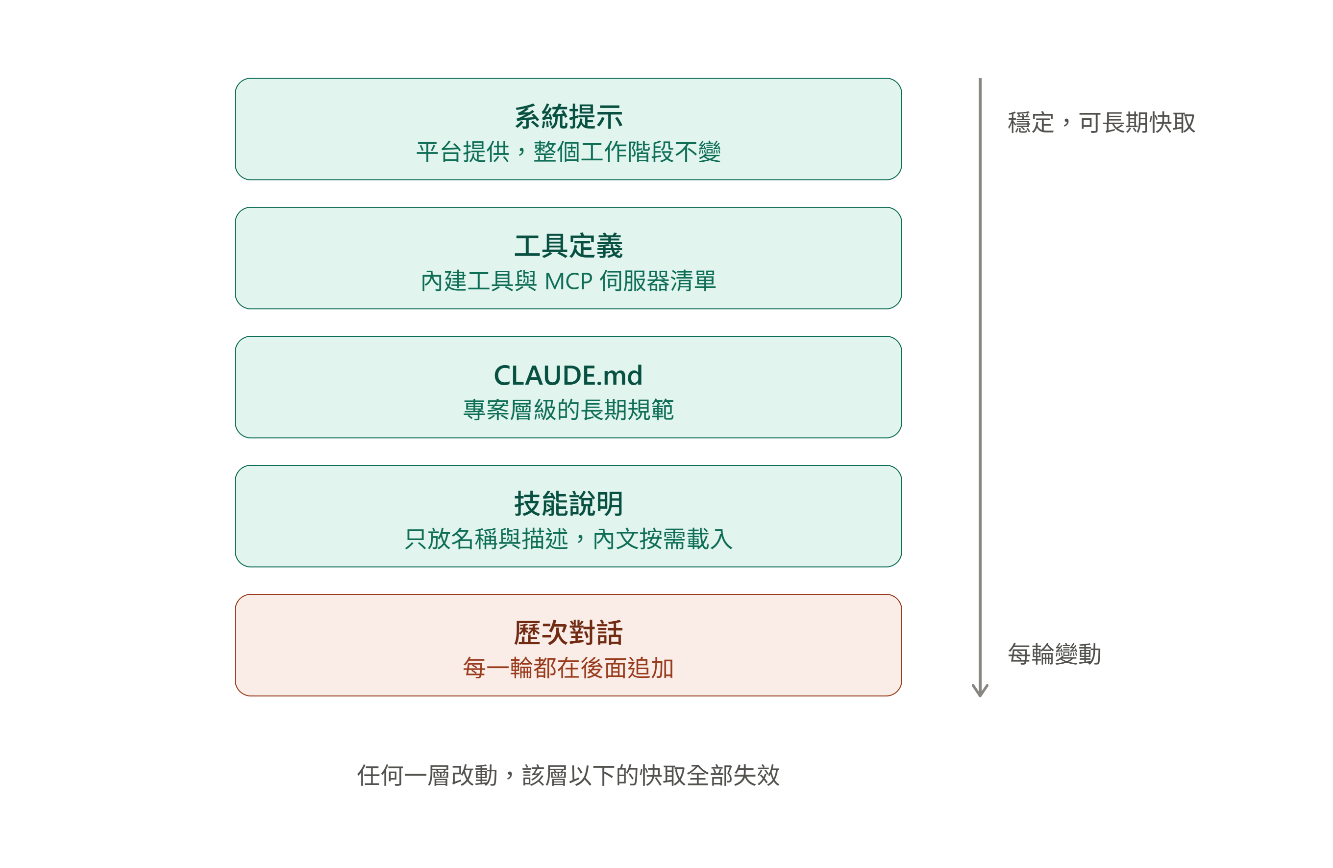
而工具定義正好是最容易變動的一段,因為它取決於當下連上了哪些 MCP 伺服器、載入了哪些外掛(plugin)。一個在對話進行到一半才連上線的 MCP 伺服器,就足以讓整個工作階段的快取歸零。
範例1:使用 /cost 檢視快取狀態
在 2026 年 8 月底的版本更新之後,/cost 指令新增了每個工作階段的 Prompt Cache 專屬欄位,包含命中率、未命中次數、重新快取掉的 token 數,以及目前的快取狀態是 warm(溫熱)或 cold(冷卻)。
使用方式很單純,在互動模式中直接輸入:
/cost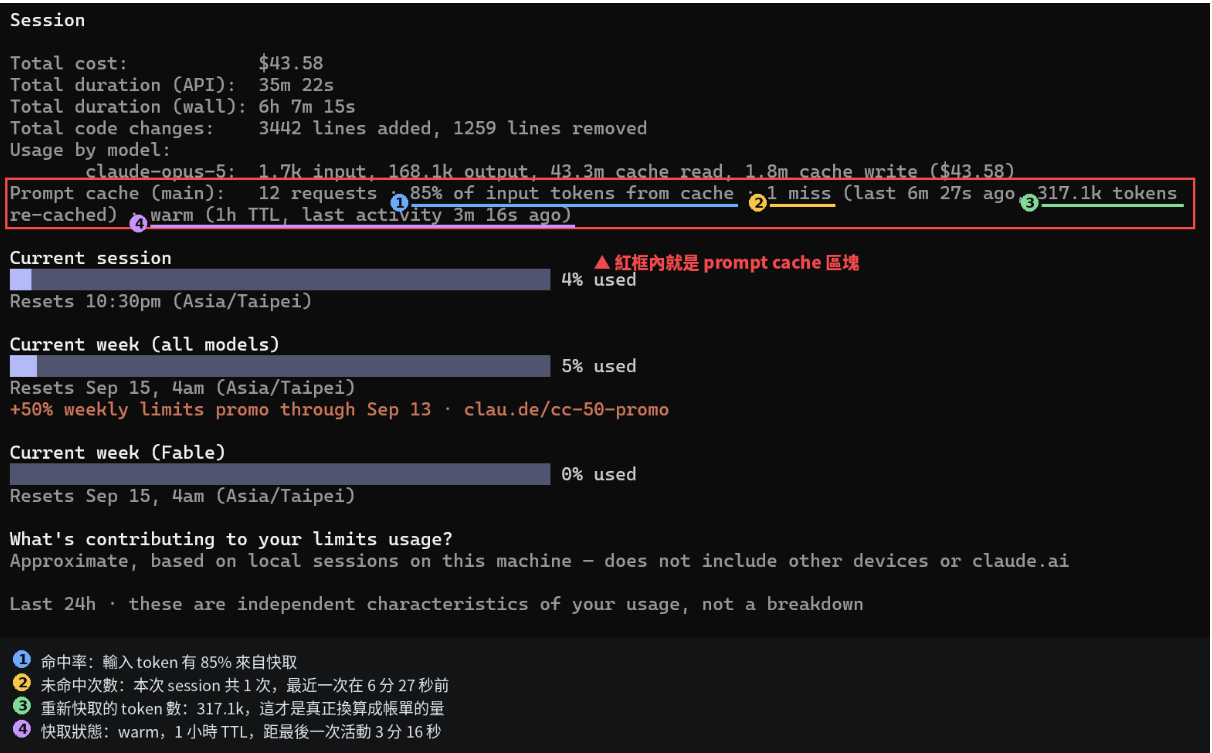
更進一步,在 2026 年 9 月初的版本中,/cost 還會顯示快取失效的推測原因,例如工具定義或系統提示發生變動、或是閒置時間超過 TTL。這一項改動讓除錯從憑空猜測變成了查表確認。
範例2:將命中率常駐顯示於狀態列
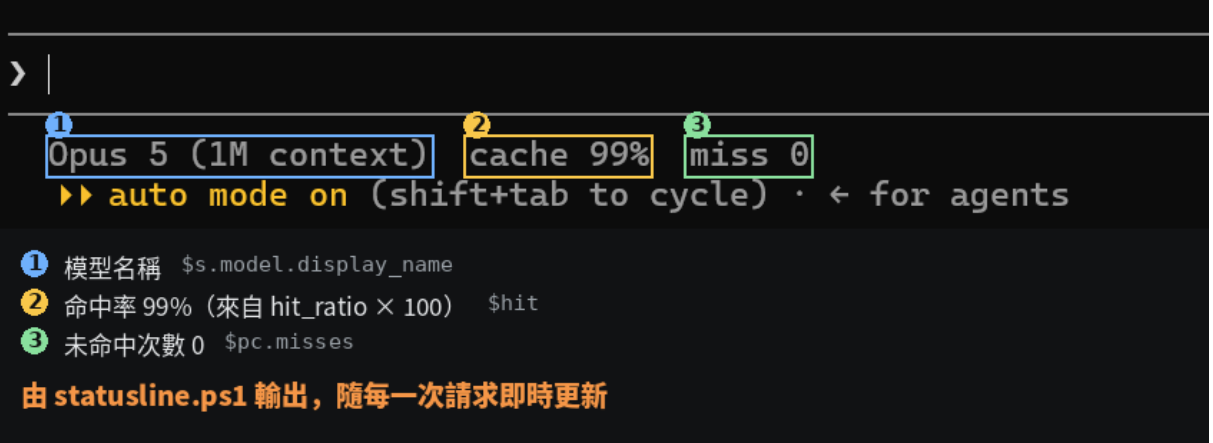
只在需要時才輸入 /cost,往往會錯過失效發生的當下。比較理想的做法是把命中率放進狀態列(status line),也就是 Claude Code 畫面底部的那一行自訂資訊。
狀態列的運作方式是:Claude Code 會將工作階段的即時狀態以 JSON 格式傳給指定的腳本,再由腳本輸出一行文字顯示出來。而在同一批更新中,這份 JSON 新增了對應的 prompt_cache 物件。
以下為在 Windows 環境中使用 PowerShell 撰寫的範例,檔案儲存為 statusline.ps1:
$raw = [Console]::In.ReadToEnd()
$s   = $raw | ConvertFrom-Json
$pc  = $s.prompt_cache
"{{0}}  cache {{1}}  miss {{2}}" -f `
    $s.model.display_name, $pc.hit_rate, $pc.misses
程式說明:
- [Console]::In.ReadToEnd():Claude Code 會將工作階段的狀態以 JSON 字串的形式寫入標準輸入,因此第一步必須把它完整讀取進來。
- ConvertFrom-Json:將讀取到的 JSON 字串轉換為 PowerShell 物件,之後即可用點號語法存取各個欄位。
- $s.prompt_cache:取得快取相關的資訊物件,其中 hit_ratio 為命中率、misses 為未命中次數。
- $hit 的轉換:hit_ratio 回傳的是 0 到 1 之間的小數而非百分比,因此必須乘以 100 再格式化。另外工作階段剛啟動時這個欄位可能還是 null,若直接運算會出錯,所以先用 $null -ne 判斷,沒有值時顯示為「-」。
- -f 格式化輸出:狀態列只會顯示腳本輸出的第一行文字,因此請將所有資訊組合成一行之後再輸出。
接著在設定檔 ~/.claude/settings.json 中註冊這個腳本:
{
  "statusLine": {
    "type": "command",
    "command": "powershell -NoProfile -File C:/Users/admin/.claude/statusline.ps1"
  }
}
範例3:調整Agent的快取存續時間
如前所述,預設的 TTL 為 5 分鐘,且自最後一次使用起算。對於開發者會離席、開會或思考較久的長流程工作來說,往往在回座之前就已經過期。針對這種情境,可以在 Agent 定義檔的 frontmatter 中設定 experimental.cacheTtl,值為 "5m" 或 "1h":
---
name: refactor-helper
description: 協助進行大型重構的長流程代理
experimental:
  cacheTtl: "1h"
---
是否該調整為 1 小時,可以用一個簡單的標準來判斷:1 小時 TTL 的寫入成本是 2 倍,因此同一份前綴必須被重複讀取三次以上才划算。長時間、低頻率互動的任務適合設定為 1 小時;短促的一問一答維持預設值即可。
範例4:檢視技能的使用狀況
在討論如何保住快取之前,有一件投資報酬率更高的事情應該先做:把沒有在使用的技能(Skill)清掉。
原因在於,已載入的技能說明位於前綴之中,它們不只佔用 context 額度,還會讓前綴變得更長,於是每一次快取失效的代價都更高。2026 年 9 月初新增的 /skill-doctor 指令(最新的版本已經建議使用/plugin + stats頁簽檢視即可),可以列出目前已載入但完全沒有被使用到的技能,以及它們各自消耗了多少 context:
/skill-doctor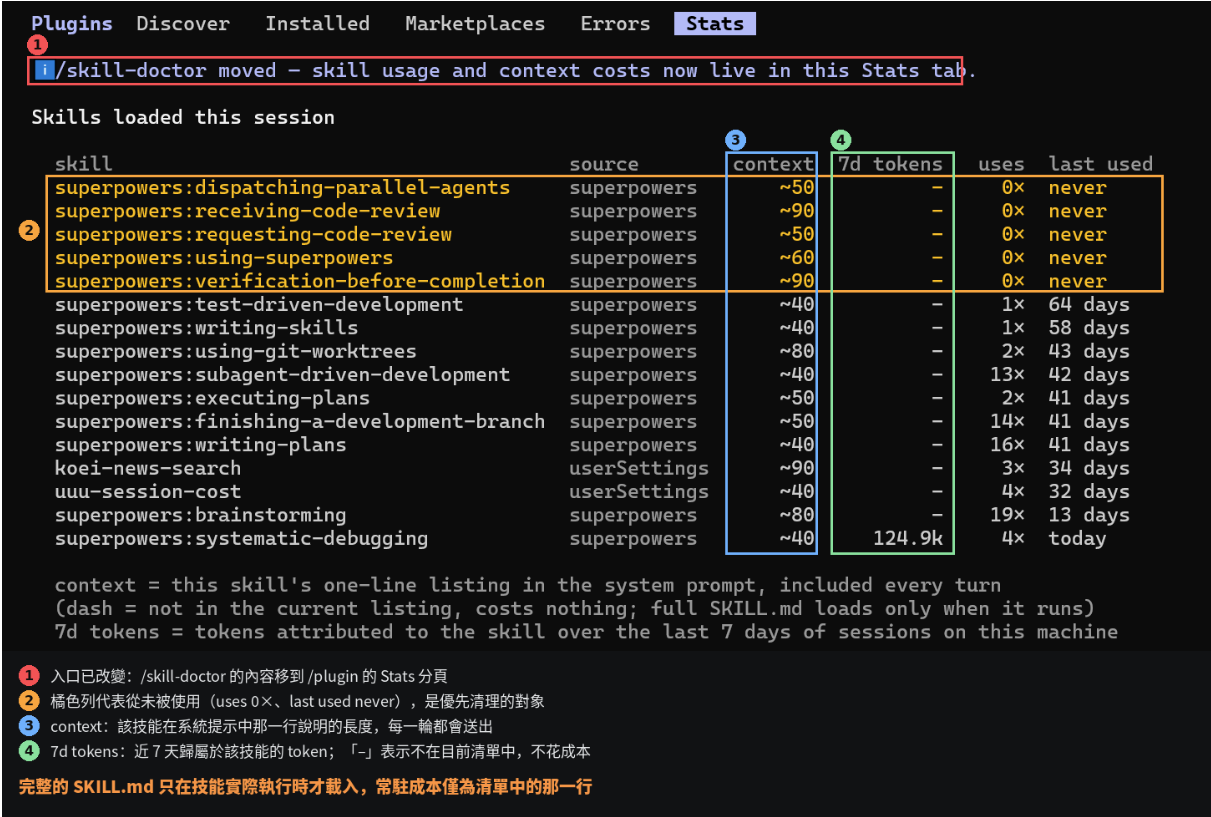
這個畫面有一個很容易誤解的地方,必須特別說明:context 欄位顯示的並不是整份 SKILL.md 的長度,而是該技能在系統提示中那一行說明的長度,數值通常落在 40 至 90 token 之間,完整的 SKILL.md 要到技能真正被執行時才會載入。
因此,把沒有在使用的技能清掉,所省下的常駐成本其實相當有限——即使安裝了二十個技能,常駐於前綴中的也不過一千多個 token,對照動輒數萬 token 的前綴並不顯著。清理的真正價值在另一個地方:降低不相關的技能被誤觸發的機率。一旦誤觸發,整份 SKILL.md 會被載入到對話之中,那才是有份量的成本,而且它發生在對話的中段。
判讀的方式是看 uses 與 last used 這兩欄。長期維持 0 次、last used 顯示為 never 的技能,代表它的描述從來沒有被匹配到,屬於可以移除的對象;而使用次數異常高的技能,則值得回頭檢查它的觸發條件是不是寫得太寬鬆。
常見的快取失效原因
以下整理實務上最常見的幾種失效情境,供各位讀者自我檢視:
- 工具清單在對話中途變動:MCP 伺服器重新連線、外掛在中途載入、或某個工具因伺服器斷線而從清單中消失,都會改寫工具定義區塊。由於工具定義位於前綴的最前端,它一旦變動,後面的內容全部作廢。在較新的版本中,中途加入的工具已改以延後定義(deferred definitions)的方式處理,情況已大幅改善。
- 在對話中途切換模型:使用 /model 切換模型時會重新送出工具定義,等同於一次完整的失效。建議將切換的時機安排在一項任務結束、context 還很短的時候。
- 恢復先前的工作階段:使用 --resume 恢復對話的過程中,工具描述可能被重新產生、MCP 工具的宣告可能在連線器重連之前就被改寫,這些都會讓恢復後的第一輪整段失效。此類問題在近期版本中已密集修補。
- 子代理與自訂系統提示:以 --system-prompt 或 --append-system-prompt 啟動的工作階段與子代理(subagent),過去會在每一輪重新產生系統提示與工具定義,相當於固定浪費。若有在使用多代理工作流程,升級版本本身就是最有效的成本改善。
- 截圖與大量輸出累積:這一項的機制比較特別,值得單獨說明,請見下一節。
截圖為什麼會讓每一輪都失效
前面四種情境都是「某個東西變動了」,而截圖這一項的成因是「東西太多,Claude Code被迫改寫先前的內容」。
根據官方文件,單次請求的影像數量上限為 100 張(context 窗口為 20 萬 token 的模型)或 600 張(其他模型),單張尺寸上限為 8000×8000 px。而其中最關鍵的一句規則是:所有影像區塊都計入這個門檻,包含在後續輪次中重新送出的舊影像,以及包在 tool_result 之中回傳的截圖。此外,一旦同一個請求內超過 20 張影像,每一張的尺寸上限就會被收緊;標準端點另外還有 32MB 的請求大小限制。
請注意「重新送出的舊影像也要計入」這一句。對話的運作方式是每一輪都把先前的內容整包再送一次,因此影像是累積的,而不是用完就消失。當累積量逼近上限時,客戶端為了讓請求能夠成功送出,必須對較早的影像做處理——縮小、移除、或以文字佔位符取代。而這個處理發生在前綴的中段,於是每一輪的前綴都跟上一輪不同,結果就是每一輪都完全未命中。
那麼要多密集才會發生?20 張是第一個轉折點,100 張是系統上限。以 UI 除錯或自動化測試這類每一輪都截一張圖的工作來說,二十幾輪就會碰到第一個門檻。不過各位讀者並不需要去記這些數字,只要觀察即可:如果 /cost 顯示的未命中次數隨著每一輪穩定增加,而且重新快取的 token 數持續維持在很大的值,通常就是這個原因。
處理方式是執行 /compact 把累積的影像收斂掉。但這裡必須誠實說明一件事:壓縮本身一定會讓快取歸零,它並不是免費的清理動作。真正的判斷依據是一筆簡單的算術——已經陷入每輪必定失效的狀態時,不壓縮等於每一輪都付一次全價;壓縮則是一次性付一次重寫的成本,之後恢復命中。因此只要後續還要再進行兩輪以上,壓縮就是划算的。
更好的做法則是一開始就不要讓截圖堆積:請 Claude 把截圖存成檔案,需要時再以檔案路徑讀取,或是在一段密集的視覺除錯結束之後直接開啟新的工作階段。
壓縮是一道無法避免的限制
上述五種情境都有辦法避免,但有一狀況種無法,那就是壓縮(compaction)。
不論是手動執行 /compact 或是 context 額度用盡時自動觸發,壓縮的本質都是把前面的對話換成一份摘要,於是整段前綴被重寫,快取必然歸零。這並不是缺陷,而是壓縮的定義。開發者能做的不是避免它,而是控制它發生的時機。
比較好的習慣是:在一項任務自然結束、正要更換主題的時候主動執行 /compact,此時損失的是本來就不再需要的 context;若是讓它在追查問題追到一半時自動觸發,損失的則是正在使用中的脈絡,往往還要再花好幾輪把狀態補回來,而那幾輪又是全新且未命中的 token。
除了時機之外,也可以從降低壓縮的觸發頻率著手。2026 年 9 月初新增的 bashOutputMaxChars 與 taskOutputMaxChars 兩項設定,可以調整指令與背景任務的輸出在存成檔案之前,有多少內容會直接進入對話之中,上限為 12.8 萬字元:
{
  "bashOutputMaxChars": 30000,
  "taskOutputMaxChars": 30000
}
此設定的慎重取捨。因為調高數值可以減少 Claude 來回讀取檔案的次數,但代價是 context 成長得更快、更早撞上壓縮;而調低則相反。輸出普遍簡短的專案可以放寬,而會產生大量建置日誌的專案則建議維持保守設定。
另外值得一提的是,具備 100 萬 token context 的模型在這件事情上已經做過調整,工作階段會在接近上限時才進行壓縮。context 窗口更大的直接好處,就是壓縮的次數更少,快取自然也活得更久。
哪些情況不需要在意命中率
本文一路都在說明如何保住快取,但有幾種情況再追下去只是徒勞,在此一併說明。
- 一次性的批次腳本:使用 claude -p 執行完就結束、前綴只會出現一次的任務,快取寫入的 1.25 倍反而變成淨損失。這類工作應該優化的是提示本身的長度,而不是快取。
- 過短的對話:前綴不夠長時,快取寫入的成本門檻本身就會吃掉收益。實務上要到前綴具備一定規模、而且會被重複讀取兩次以上,5 分鐘 TTL 才開始划算,1 小時 TTL 則需要三次以上。三兩句就結束的問答並不在這個範圍之內。
- 為了保住快取而改變工作方式:有些開發者知道切換模型會造成失效,於是整天使用不合適的模型硬撐;也有人因此不敢安裝外掛、不敢連接 MCP 伺服器。這是本末倒置,因為那些工具帶來的產出價值,遠遠高於一次快取重寫的成本。
判斷的原則可以很簡單:如果某個決定會讓您少完成一件事,那它就不是成本優化,而只是省小錢。
結論
Prompt Cache 的命中率,是 Claude Code 成本管理中最關鍵、卻也最常被忽略的一個指標。它的價值在於:同樣的工作量、同樣的 token 數,命中與否會反映出數十倍的帳單差距。
建議的導入步驟很單純:先以 /cost 建立基準、再把命中率放進狀態列養成觀察習慣、接著針對本文列出的五種失效情境逐一檢視自己的操作方式。驗證時請挑選一項具代表性的任務,在調整前後各完整執行一次,並記錄命中率、未命中次數與重新快取的 token 數這三個數字。其中第三個數字最為重要,因為命中率是比例,會被對話長度稀釋,而重新快取的 token 數才是真正換算成帳單的計量。
最後要提醒的是,這一切的目的並不是要求各位少用 Claude Code。為了保住快取而不敢安裝外掛、不敢切換模型,反而是本末倒置。正確的做法是把這些必要的動作集中在對話早期完成,而不是完全不做。如有興趣進一步了解,可參考下方:
- 官方文件:https://docs.claude.com/en/docs/build-with-claude/prompt-caching
- Claude Code 的版本更新紀錄:https://code.claude.com/docs/en/changelog
若您對於學習AI程式開發有更多的興趣,歡迎參考恆逸教育訓練中心Claude Code課程可以了解更多的技巧喔!
您可在下列課程中了解更多技巧喔!


0 意見:
張貼留言